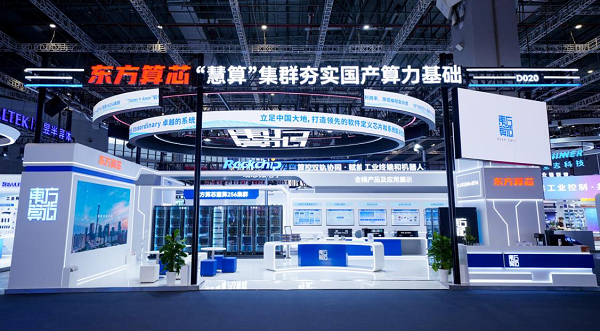
2026年10月12日至16日,第二十六届中国国际工业博览会在国家会展中心(上海)举行。展会首次设立集成电路展(国芯展),覆盖芯片设计、晶圆制造、封测、半导体装备、核心材料在内的全产业链,集中展示国产芯片从技术突破到规模化落地的产业跃升。
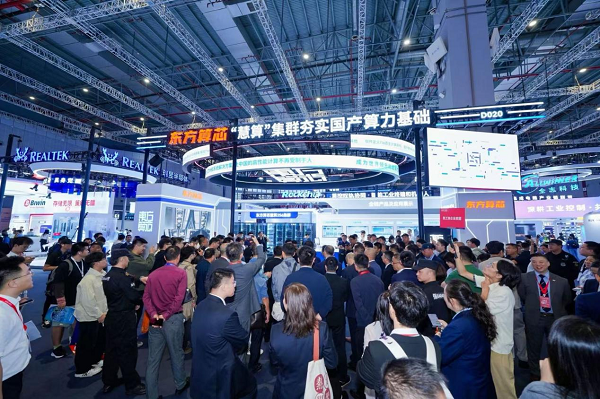
东方算芯以“全国产训练集群系统化部署”为主题登陆展会现场,正式对外披露DF1000算力芯片及全国产训练集群全链路落地成果——全程仅用24个月完成从芯片研发、全栈软件适配到集群系统规模化部署的完整闭环,且实现多个主流大模型长周期稳定运行。这一高效落地的背后,不仅是企业管理与人才能力的体现,更彰显了近存计算技术路线相对于传统制程路线的底层效率优势,为国产算力产业化提供了全新路径。
24个月全栈攻坚,跑出算力产业化加速度
国产算力落地长期面临研发链条冗长、串行迭代周期漫长、跨环节协同难度高等行业痛点。东方算芯跳出传统“芯片流片、再做软件适配、最后搭建集群”的串行开发模式,采用芯片设计、编译器与算子库开发、集群系统架构三大模块并行研发、协同验证,在同一周期内同步完成DF1000算力芯片设计、全栈软件体系开发、128卡训练集群搭建以及大模型训练适配全链条能力建设。
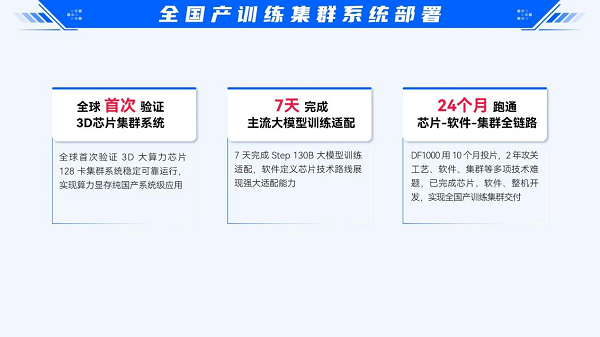
在交付层面,DF1000加速卡完成了算力、显存带宽、通信带宽、功耗温度等全项规格测试,11项BF16算子测试一次性全部通过,彰显了出色的硬件素质。集群端构建起“部署-联调-压测-试训-验收”标准化交付体系,从机房基建适配到集群具备商用大模型训练能力实现全流程可控。从项目立项到集群具备商用级训练能力,全程仅用时24个月,显著优于行业常规研发周期。
高效落地的背后,是企业内部跨环节协同能力与全国产供应链体系的强力支撑。研发、供应链、工程交付、客户验证各环节高效联动,大幅减少了跨部门沟通损耗与重复工作。同时,全国产供应链的深度配合,为从芯片到整机的快速落地与规模化复制打下坚实基础。
精干团队支撑大集群稳定运行,印证人才与技术硬实力
高端算力产业横跨芯片架构、底层软件、集群调度、AI适配与工程运维多领域,技术壁垒高、体系复杂度极高,对全链条技术人才提出严苛要求。东方算芯核心研发团队以精干规模覆盖芯片架构设计、软件编译器、算子优化、集群调度系统和大模型适配全技术栈,让技术决策更高效,迭代响应更敏捷,为快速产业化落地提供坚实人才保障。
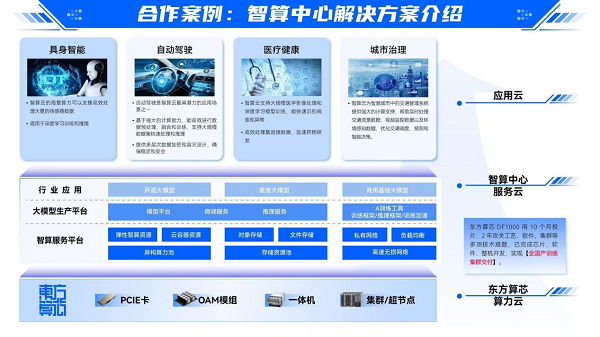
目前,一支精简运维团队即可支撑规模化训练集群持续稳定运转,承载Llama2-70B、JYXC-130B、Step130B等多款大模型训练任务。其中,Step 130B大模型训练适配仅用时7天,充分展现了软件定义芯片技术路线对快速迭代大模型的强大适配能力。该集群顺利完成72小时不间断连续训练验证,训练精度达标,稳定性满足商用级长周期训练需求。集群搭载智能调度、故障自愈和全维度监控体系,大幅降低人工干预需求。首批试点客户对集群稳定性、训练效率和服务响应速度均给出正面评价,方案可快速复制适配不同规模算力需求,具备良好的商业化落地能力。
跳出制程依赖,近存计算形成低投入高产出新范式
24个月全链路极速落地,主要源于东方算芯差异化的底层技术范式革新。对比传统算力方案,该路线在硬件架构、研发模式、运维体系、供应链四个维度形成系统性差异化竞争力。
在硬件架构层面,传统算力芯片采用“计算核心+外置存储”的分离架构,存储墙瓶颈长期制约算力释放,企业需通过不断升级制程、堆叠硬件来弥补性能短板,研发与硬件投入水涨船高。东方算芯跳出单纯比拼纳米制程的固有思路,采用“软件定义+3D堆叠近存计算”技术路线,DF1000是国内首颗采用DRAM-Logic晶圆级混合键合3D垂直封装的AI芯片,该芯片利用3D混合键合将计算层与存储层垂直堆叠集成,把互连间距压缩至亚微米,互连密度、带宽密度实现数量级增长,访存带宽达到6.4TB/s,一举破解存储、带宽、功耗三大行业瓶颈,有力承载大模型训练与推理等高负载算力任务。依托国内成熟工艺即可实现等效高端算力,无需追逐最先进制程,从根源降低研发门槛与硬件投入,大幅提升产业化投入产出比。
在运维层面,异构硬件和混合架构往往会带来兼容性维护、故障定位、性能调优等长期问题,集群规模越大,运维人力和系统复杂度越高。东方算芯打造全栈同构技术体系,显著降低系统复杂度,搭配自研智能运维工具,少量人员即可支撑大规模集群稳定运行,大幅降低长期运营成本,适配国内智算中心规模化建设需求。
在供应链层面,传统高端算力芯片高度依赖先进制程与海外高端器件,供应链受外部环境约束,产能扩张周期长,成本可控性弱。东方算芯立足全国产成熟制程供应链,供应链安全自主可控,产能扩张速度更快、交付周期更短,能够快速响应国内信创、行业AI等领域的算力市场需求。
近存算力进入规模化落地期,产业空间广阔
有行业人士认为,当前国内信创持续深化、行业AI加速落地,自主可控、高性能、高性价比算力底座成为产业刚需。东方算芯DF1000芯片及其全国产集群已完成全链路验证,标准化交付体系成熟,可快速拓展至千卡级智算集群,覆盖大模型预训练、行业微调、智能推理等多元场景。这套全新算力范式,走出一条不依赖先进制程、低投入、快落地、可规模化的国产算力发展新路,有效降低海外技术与供应链带来的约束,为国内智算中心建设、千行百业智能化转型筑牢自主算力底座。
在本届工博会国芯展上,东方算芯展示的不仅是DF1000芯片及全国产训练集群的落地成果,更传递出一个清晰信号:国产算力已跑通一条不依赖先进制程的突围路径。24个月全栈落地并非个例,而是近存计算技术路线的必然结果。随着规模化应用持续推进,该路线将成为支撑中国算力自主的核心技术路径之一,为国产算力与AI产业高质量发展提供核心支撑。